Una pipeline (catena di montaggio) è il "percorso" attraverso il quale viene eseguita un istruzione.
Facciamo l'esempio tipico, ovvero quello delle catene di montaggio tradizionali.
"Anticamente" i processori funzionavano come gli artigiani... ovvero avevano una lista di ordini (le istruzioni da eseguire) e, ad una ad una, le eseguivano partendo, per ognuna, dalla materia prima fino ad arrivare al prodotto finito.
Se nella prima fase si usava la sega circolare e la sega circolare serviva solo nella prima fase allora la sega circolare era usata solo nella prima fase.
Ci si è resi conto abbastanza presto che la cosa era poco efficiente... se una parte del chip viene usata solo in una "fase" dello svolgimento di un istruzione vuol dire che spesso è inutilizzata, e consuma energia inutilmente.
La domanda che ci si è posti è stata quindi : perché non usare la sega circolare continuamente?
La risposta ovviamente era "perché c'è un solo artigiano".
Ecco che è venuto fuori il concetto di "pipeline", ovvero di catena di montaggio...
In una catena di montaggio anziché un artigiano che prende una materia prima e la lavora fino ad avere il prodotto finito (l'istruzione eseguita) ci sono diversi operai (i vari "stage", di cui parleremo in seguito), ognuno dei quali svolge una piccola parte del lavoro.
Dov'è il vantaggio ?
Il vantaggio è che se l'esecuzione di un istruzione è "divisibile" in cinque "stage" (o passi, o fasi... come volete voi) allora una pipeline può "lavorare" a cinque istruzioni contemporaneamente...
I processori attuali sono tutti concepiti in questa maniera, e
la velocità di clock è il tempo che ci mette un istruzione a passare da uno stage al successivo e non il tempo che impiega ad essere eseguita.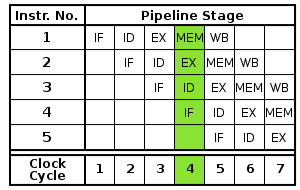
Nell'immagine l'evoluzione "nel tempo" di un frammento di codice attraverso una pipeline.
Gli stage indicati sono quelli individuati "classicamente", ovvero IF = Instruction Fetch (caricamento del comando), ID = Instruction Decode (decodifica), EX = Execution (esecuzione dell'istruzione), MEM = Memory access (accesso alla memoria), WB = Write Back (scrittura nei registri).
Questa è la pipeline "tipica" di un processore RISC moooolto vecchio, ed è un buon punto di partenza per capire come funziona "il tutto"... c'è da notare che oggigiorno le CPU, sia per poter salire di clock sia per altre questioni, hanno molti più stage (i vecchi Pentium 4 Prescott mi pare abbiano fatto il record con 31 stage).
Per capire "dove siamo arrivati" a seguito c'è lo schema della pipeline di uno SPE del CELL

Come prima infarinatura direi che basta

 Login
 Chat [0]
 FAQ
 Cerca


 Wannabe tecnico :



 .