The Dark Side of Hardware Upgrade Forum

...bringing out the worst in you since 2003...
Oggi è mar ott 13, 2026 6:54 pm

Tutti gli orari sono UTC +1 ora


-->
-->

Apri un nuovo argomento Rispondi all’argomento  [ 12 messaggi ] 
Autore Messaggio
 Oggetto del messaggio: Wannabe tecnico - Le pipeline.
MessaggioInviato: dom nov 21, 2010 9:52 am 
Schiavo
Avatar utente
Iscritto il: mer lug 14, 2010 5:55 pm
Messaggi: 24969
Una pipeline (catena di montaggio) è il "percorso" attraverso il quale viene eseguita un istruzione.

Facciamo l'esempio tipico, ovvero quello delle catene di montaggio tradizionali.
"Anticamente" i processori funzionavano come gli artigiani... ovvero avevano una lista di ordini (le istruzioni da eseguire) e, ad una ad una, le eseguivano partendo, per ognuna, dalla materia prima fino ad arrivare al prodotto finito.
Se nella prima fase si usava la sega circolare e la sega circolare serviva solo nella prima fase allora la sega circolare era usata solo nella prima fase.

Ci si è resi conto abbastanza presto che la cosa era poco efficiente... se una parte del chip viene usata solo in una "fase" dello svolgimento di un istruzione vuol dire che spesso è inutilizzata, e consuma energia inutilmente.

La domanda che ci si è posti è stata quindi : perché non usare la sega circolare continuamente?
La risposta ovviamente era "perché c'è un solo artigiano".
Ecco che è venuto fuori il concetto di "pipeline", ovvero di catena di montaggio...
In una catena di montaggio anziché un artigiano che prende una materia prima e la lavora fino ad avere il prodotto finito (l'istruzione eseguita) ci sono diversi operai (i vari "stage", di cui parleremo in seguito), ognuno dei quali svolge una piccola parte del lavoro.

Dov'è il vantaggio ?
Il vantaggio è che se l'esecuzione di un istruzione è "divisibile" in cinque "stage" (o passi, o fasi... come volete voi) allora una pipeline può "lavorare" a cinque istruzioni contemporaneamente...

I processori attuali sono tutti concepiti in questa maniera, e la velocità di clock è il tempo che ci mette un istruzione a passare da uno stage al successivo e non il tempo che impiega ad essere eseguita.
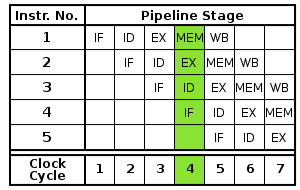
Immagine

Nell'immagine l'evoluzione "nel tempo" di un frammento di codice attraverso una pipeline.
Gli stage indicati sono quelli individuati "classicamente", ovvero IF = Instruction Fetch (caricamento del comando), ID = Instruction Decode (decodifica), EX = Execution (esecuzione dell'istruzione), MEM = Memory access (accesso alla memoria), WB = Write Back (scrittura nei registri).

Questa è la pipeline "tipica" di un processore RISC moooolto vecchio, ed è un buon punto di partenza per capire come funziona "il tutto"... c'è da notare che oggigiorno le CPU, sia per poter salire di clock sia per altre questioni, hanno molti più stage (i vecchi Pentium 4 Prescott mi pare abbiano fatto il record con 31 stage).

Per capire "dove siamo arrivati" a seguito c'è lo schema della pipeline di uno SPE del CELL

Immagine

Come prima infarinatura direi che basta :D
_________________
Immagine Wannabe tecnico : Le pipeline | Registri, cache ed altre amenità | DMA, multitasking, interrupt e CPU "OS friendly" (work in progress) Immagine
Top
 Profilo Non connesso  
 
 Oggetto del messaggio: Re: Wannabe tecnico - Le pipeline.
MessaggioInviato: dom nov 21, 2010 10:24 am 
Schiavo
Avatar utente
Iscritto il: mer lug 14, 2010 5:55 pm
Messaggi: 24969
Qualche considerazione sugli stage.

Prima abbiamo visto come un istruzione può essere "divisa" in stage... ma non abbiamo parlato granché degli stage in sé.
Innanzitutto... quanto ci mette uno stage ad essere eseguito ?
Abbiamo detto prima che uno stage dura un ciclo di clock, ma non è esattamente vero... è più giusto dire che lo stage più lento dura quanto un ciclo di clock, gli altri stage durano meno.
Per cui se uno stage (mettiamo, EX) richiede TRE volte il tempo necessario agli altri stage avremo comunque una "perdita", perché ad ogni ciclo di clock le altre unità perdono due terzi del tempo assegnato aspettando che EX finisca.

Nella pratica cosa vuol dire ? Vuol dire che (nell'esempio) EX limita pesantemente la velocità di clock ottenibile e quindi la resa prestazionale dell'insieme.
Per risolvere il problema rimane poco da fare... le soluzioni disponibili sono due, e si usano entrambe.
La prima è quella di usare due o più (ma tipicamente DUE) pipeline, la seconda è quella di fare stage più stage in modo da averli "corti" e quindi "brevi".
Ogni stage è una specie di "sub unità" che interagisce con le precedenti e le successive, ha i suoi registri interni e la sua "logica"... per cui il "lato negativo" della cosa è che più stage si fanno più si "complica" (come numero di transistor, complessità generale etc etc) il tutto.

A loro volta essendo gli stage "unità" hanno una loro "autonomia" per cui uno stage può, a seconda del compito che di volta in volta è portato a svolgere, comunicare coi precedenti e coi successivi... e qui le cose si complicano.
Mettiamo che un istruzione richieda un accesso "extra" alla memoria per andare avanti... ovviamente "ci vorrà del tempo" (dei cicli extra per eseguire completamente lo stage) e quindi per "un po'" lo stage non potrà fare altro... tocca quindi aggiungere un "segnale" che avverta chi stà prima che c'è un "blocco" nella catena e che quindi si fermino fino a quando non si "libera" lo stage.
Questo è un esempio di un wait state introdotto da uno stage o, per meglio dire, una bolla (bubble):

Immagine

Questi sistemi di sincronizzazione fra gli stage (essenzialmente due: bubble e squashing) sono il grosso problema delle architetture a pipeline.
_________________
Immagine Wannabe tecnico : Le pipeline | Registri, cache ed altre amenità | DMA, multitasking, interrupt e CPU "OS friendly" (work in progress) Immagine
Top
 Profilo Non connesso  
 
 Oggetto del messaggio: Re: Wannabe tecnico - Le pipeline.
MessaggioInviato: dom nov 21, 2010 10:56 am 
Schiavo
Avatar utente
Iscritto il: ven feb 03, 2006 10:50 pm
Messaggi: 5164
Località: Reggio Calabria --> London
Un problema molto importante e' quando si ha un branch-misprediction che comporta uno svuotamento completo della pipeline.
In pratica se nel codice ci si trova davanti ad una scelta che dipende da una variabile potremmo semplicemente attendere che la condizione dipendente dalla variabile venga risolta e dunque decidere quale ramo di esecuzione eseguire.
Pero' nei processori moderni invece c'e' un apposita unita' il branch predictor, che si occupa di prevedere qual'e' il ramo di esecuzione che ha una probabilita' maggiore di essere eseguito.
In questo caso pero', se si ha un errore di predizione, allora bisogna buttare via tutte le istruzioni eseguite dal branch in poi svuotando la pipeline e ricominciare sull'altro branch.
Un esempio tipico e' un ciclo:
Codice:
while (i < 1000) {
    do something;
}

che solitamente viene tradotto in assembly in qualcosa di simile:
Codice:
label_i:
if (i < 1000) {
    do something
} else {
    jump label_i;
}

Ovviamente questo e' solo psedocodice, in assembly ci sono le varie istruzione JNE, JNZ &co. che combinano in un'unica istruzione la verifica della condizione ed il salto.
Ebbene cosa si puo' notare da questo codice?
semplicemente che per 1000 volte il branch giusto da eseguire e' quello di "do_something", mentre dopo che il contatore raggiunge 1000 si dovra' eseguire l'altro.
In pratica questa e' una versione MOOOOLTO semplificata di alcune tecniche che i branch predictor usano.
In caso di errore di predizione un processore con le pipeline corte sara' avvantaggiato poiche' sara' costretto a buttare via un numero di istruzioni minore rispetto ad un processore con la pipeline lunga.
Per questo motivo il pentium 4, basato su un'architettura chiamata netburst, il cui scopo principale era di avere pipeline MOLTO lunghe per vincere la corsa ai mhz con AMD ai tempi, in certi tipi di applicazioni era molto piu' lento di quanto ci si aspetterebbe.
Esempio tipico e' la compilazione. Il processo di compilazione di un software e' composto da un'enorme quantita' di branch e spesso e volentieri il branch predictor, per quanto complesso ed evoluto, non ce la fa a ritornare il risultato corretto e dunque rallenta l'esecuzione delle istruzioni.
Un'altra tecnica usata per questo problema e' quella gia' citata da conte della "shadow pipeline" in pratica e' la duplicazione di una parte della pipeline che permette di eseguire entrambi i branch contemporaneamente.
Ovviamente questo ha un costo in termini di transistor sul chip.
_________________
:scongiuri:
Top
 Profilo Non connesso  
 
 Oggetto del messaggio: Re: Wannabe tecnico - Le pipeline.
MessaggioInviato: dom nov 21, 2010 11:09 am 
Schiavo
Avatar utente
Iscritto il: mer lug 14, 2010 5:55 pm
Messaggi: 24969
Si, il caso in cui si "sbaglia" nella predizione c'è quello che ho chiamato sopra "squashing", ovvero l'azzeramento di tutti i "prodotti intermedi" degli stage precedenti.
Il primo processore consumer ad introdurre un sistema a pipeline è stato il 486, con un sistema di branch prediction decisamente fascista: "i salti condizionati non avvengono, mai"... il risultato era che laddove c'era un salto condizionato era automatico lo squashing :pua:.
Oggi il problema dei salti esiste ancora, ma ci sono vari modi per minimizzarlo, alcuni legati ai BPB (Branch predition buffer) ed altri molto più "rudi" (gli SPE ad esempio ragionano così "il prossimo salto condizionato probabilmente non avverrà, a meno che l'istruzione di salto condizionato non sia anticipata da un prefisso che dice il contrario").

La "bontà" di un processore "general purpose" è in buona parte legata a come si comporta davanti ai salti condizionati, e questo perché il codice strutturato è notoriamente pieno di questo genere di salti ed una buona unità di predizione può fare la differenza.

Poi, per dirla chiaramente... se un branch è stato predetto correttamente non c'è praticamente penalità (le istruzioni continuano ad essere eseguite al ritmo di una* per ciclo), se c'è stato un errore bisognerà attendere tanti cicli di clock quanti sono gli stage della CPU prima che venga eseguita l'istruzione successiva (es. 31 sui Prescott contro i 12 degli Athlon64).

* o due, ma lo vedremo in seguito
Spoiler: show
Il codice dovrebbe essere questo:
Codice:
before:
mov Acc,i
cmp Acc,1000
jge after
(...do something...)
jmp before
after:

Ed il punto "caldo" è quel jump if greater or equal. (Acc è il registro accumulatore, un general purpose tipo AX/EAX/RAX su x86, r3 su PPC e così via)
_________________
Immagine Wannabe tecnico : Le pipeline | Registri, cache ed altre amenità | DMA, multitasking, interrupt e CPU "OS friendly" (work in progress) Immagine
Top
 Profilo Non connesso  
 
 Oggetto del messaggio: Re: Wannabe tecnico - Le pipeline.
MessaggioInviato: dom nov 21, 2010 11:34 am 
Lo scemo del forum
Lo scemo del forum
Avatar utente
Iscritto il: ven ago 31, 2007 5:30 pm
Messaggi: 31524
Località: Trezzo sull'Adda (MI)
thread molto interessante.

Go on 8)
_________________
Immagine - Amare la Formattazione è la Soluzione al 90% dei Problemi della Vita
Top
 Profilo Non connesso  
 
 Oggetto del messaggio: Re: Wannabe tecnico - Le pipeline.
MessaggioInviato: dom nov 21, 2010 11:52 am 
Schiavo
Avatar utente
Iscritto il: mer lug 14, 2010 5:55 pm
Messaggi: 24969
Nel caso specifico degli x86 (parto da lì, poi faccio un discorso più generale) il problema che s'è fatto via via più pressante è stato l'ISA abnorme ed in parte obsoleto.
Gli x86 sono fra i piedi da decenni, ed hanno un set d'istruzioni enorme e strutturato malissimo, cond'istruzioni di dimensioni variabili con allineamenti "casuali" ed istruzioni INUTILI che vengono mantenute solo per compatibilità (tipo quelle per il BCD).
Per ovviare a questo problema s'è usato un sistema molto particolare, che è in voga ancora oggi, anche se in modo abbastanza diverso da processore a processore e da casa a casa.
In pratica i processori attuali non sono quel che sembrano... lo stage di "decode" non fa altro che prendere le istruzioni x86 e "trasformarle" in una o più instruzioni DI UN ALTRO TIPO che vengono poi eseguite nativamente dal processore...

Questo e l'esistenza oramai ubiqua nei processori di due pipeline parallele quasi identiche ha portato ad altre interessanti "possibilità".

Facciamo un passo indietro... molte CPU fin dai tempi del 486 hanno non una ma DUE pipeline (su Intel chiamate rispettivamente U e V) che possono eseguire due istruzioni contemporaneamente.

Questa contemporaneità è quasi sempre possibile, ma ci sono due ovvi vincoli:
1. le due istruzioni non possono usare gli stessi operandi (non puoi parallelizzare A=B+C e D=A-1).
2. bisogna che le due istruzioni possano stare sulle due pipeline.

La seconda dipende in buona parte da com'è fatto il chip... alcune operazioni sono abbastanza semplici che qualsiasi pipeline può realizzarle, altre sono più complesse quindi il necessario per eseguirle è presente solo in UNA pipeline.

Nasce così l'esigenza di un "sistema" che permetta di usare il più possibile le due pipeline.
E qui si distinguono due tipi di processori: gli In Order e gli Out of Order.
_________________
Immagine Wannabe tecnico : Le pipeline | Registri, cache ed altre amenità | DMA, multitasking, interrupt e CPU "OS friendly" (work in progress) Immagine
Top
 Profilo Non connesso  
 
 Oggetto del messaggio: Re: Wannabe tecnico - Le pipeline.
MessaggioInviato: dom nov 21, 2010 12:09 pm 
Schiavo
Avatar utente
Iscritto il: mer lug 14, 2010 5:55 pm
Messaggi: 24969
I processori In Order e quelli Out of Order.

I processori In Order sono abbastanza semplici, prendono le prossime due istruzioni, se sono parallelizzabili le mettono sulle due pipeline e via, altrimenti prendono la prima delle due e la mettono sulla pipeline su cui può essere eseguita, ed aspettano il ciclo successivo.
Il loro svantaggio è che possono lasciare inattiva una pipeline per buona parte dei cicli, dimezzando di fatto il numero d'istruzioni eseguite.
Per evitare ciò sono stati pensati i processori Out of Order, in pratica questi processori hanno uno stage che anziché prendere solo le prime due istruzioni ne prende X (dipendentemente dall'implementazione e dalle istruzioni stesse) e le sposta in modo che possano essere parallelizzate.
Ad esempio il frammento:
Codice:
A=B+C;
D=A-1;
E=11;

...non è parallelizzabile, ma un OoO può "riadattarlo" in:
Codice:
A=B+C;
E=11;
D=A-1;

...e parallelizzarlo.

E qui si apre una parentesi, ovvero "quanto bravi sono i programmatori ed i compilatori".
In generale se i programmatori/compilatori fossero furbissimi l'OoO sarebbe inutile, perché il codice sarebbe già "scritto" "parallelizzabile", nella pratica però non si può sperare che il codice venga ottimizzato per uno specifico processore aventi specifiche pipeline, e non ha neanche senso sperarci... per cui l'OoO è effettivamente utile, e comunque nei casi di CPU "ibride" che "reinterpretano" il codice è impossibile parallelizzare in fase di compilazione.
_________________
Immagine Wannabe tecnico : Le pipeline | Registri, cache ed altre amenità | DMA, multitasking, interrupt e CPU "OS friendly" (work in progress) Immagine
Top
 Profilo Non connesso  
 
 Oggetto del messaggio: Re: Wannabe tecnico - Le pipeline.
MessaggioInviato: dom nov 21, 2010 12:12 pm 
Schiavo
Avatar utente
Iscritto il: mer lug 14, 2010 5:55 pm
Messaggi: 24969
Purtroppo l'unità che si occupa dell'OoO è decisamente grossa, per cui è poco economica, sia dal punto di vista delle dimensioni sul chip sia come economia delle pipeline (nel senso che ti aggiunge stage/wait state extra).
Per questo alcune delle CPU recenti* hanno deciso di usare un approccio In Order e ricorrere al multithreading (mentre altre hanno preso la via delle VLIW).

(continua questa sera)

* Gli Atom, e le CPU di XBox 360 e la PPE Cell per dirne alcune.
_________________
Immagine Wannabe tecnico : Le pipeline | Registri, cache ed altre amenità | DMA, multitasking, interrupt e CPU "OS friendly" (work in progress) Immagine
Top
 Profilo Non connesso  
 
 Oggetto del messaggio: Re: Wannabe tecnico - Le pipeline.
MessaggioInviato: dom nov 21, 2010 12:22 pm 
Schiavo
Avatar utente
Iscritto il: ven feb 03, 2006 10:50 pm
Messaggi: 5164
Località: Reggio Calabria --> London
piu' che altro il reordering viene effettuato per eseguire senza penalita' istruzioni che dipendono da dati che devono essere letti dalla memoria.
Infatti il tempo di accesso della memoria e' dell'ordine del centinaio di cicli di clock, e se si dovesse aspettare ogni volta che si necessita un dato dalla memoria si avrebbe uno spreco allucinante di risorse.
Per questo i processori in-order come gli atom fanno decisamente cagare. :pua:
Anche la velocissima cache L1 per esempio necessita di almeno tre cicli di clock per leggere un dato, mentre la L2 e nell'ordine delle decine di cicli di clock.
Per questo motivo un'altro "trucchetto" che viene utilizzato per ottimizzare l'architettura di un processore e' la creazione di shadow registers, registri fantasma che vengono utilizzati automaticamente dal processore allocando di fatto un numero di registri superiore a quello definito dall'architettura reale del processore.
Infatti uno dei piu' grossi vantaggi del passaggio da codice x86 a 32 bit e codice x86-64 e' proprio il raddoppio del numero dei registri reali, che permette di avere un discreto aumento prestazionale dato che l'utilizzo di registri reali da parte del compilatore e' piu' efficiente dell'utilizzo degli shadow registers.
_________________
:scongiuri:
Top
 Profilo Non connesso  
 
 Oggetto del messaggio: Re: Wannabe tecnico - Le pipeline.
MessaggioInviato: dom nov 21, 2010 12:30 pm 
Schiavo
Avatar utente
Iscritto il: mer lug 14, 2010 5:55 pm
Messaggi: 24969
Nel caso di processori In Order una soluzione è quella di raddoppiare il numero di CPU logiche.
La CPU "apparirà" come se fossero DUE processori distinti (con due set di registri, e due "contesti" indipendenti) ma "down to the metal" condivideranno le stesse risorse... le stesse pipeline.
In questo caso semplicemente il primo stage s'occuperà di parallelizzare le due istruzioni successive dello stesso "core logico" o le prime istruzioni dei due core, ottenendo un generale miglioramento nell'utilizzo delle pipeline, al costo di un aumento del 10-20% sulla dimensione complessiva del processore (ovvero il necessario per "adattare" le pipeline ad un uso su due thread ed ospitare i registri dei due contesti).
Per questo un Atom single core ha DUE thread logici, la PPU di Cell ha due thread logici e lo Xenon ha sei thread logici... il ragionamento di fondo è "sono il doppio, vanno la metà e grossomodo rendono uguale".

Poi ci sono le considerazioni di TigerShark (che però riguardano le cache e la memoria in genere), che vedremo in seguito.
_________________
Immagine Wannabe tecnico : Le pipeline | Registri, cache ed altre amenità | DMA, multitasking, interrupt e CPU "OS friendly" (work in progress) Immagine
Top
 Profilo Non connesso  
 
 Oggetto del messaggio: Re: Wannabe tecnico - Le pipeline.
MessaggioInviato: lun nov 22, 2010 1:58 am 
Schiavo
Avatar utente
Iscritto il: mar lug 20, 2010 12:40 am
Messaggi: 17
Località: Kooly Noody
perfetto domani al lavoro so che leggere
_________________
Immagine

Immagine

sider ? ha scritto:
Un giorno ho visto per strada un tizio barcollante , sporco, pieno di chiazze verdi e pus, infastidiva bambine e rubava i soldi alle vecchiette: era uno che postava nel DS.

Le auto straniere non sono nel mio core businnes (cit.)
:O
Forza Morte
Top
 Profilo E-mail Non connesso  
 
 Oggetto del messaggio: Re: Wannabe tecnico - Le pipeline.
MessaggioInviato: lun nov 22, 2010 5:14 am 
Schiavo
Avatar utente
Iscritto il: mer lug 14, 2010 5:55 pm
Messaggi: 24969
Una piccola nota tecnica... le probabilità di usare entrambe le pipeline aumentano perché lo stage in ingresso può decidere di eseguire un istruzione di ogni thread per pipeline (in cui non ci sono dipendenze logiche, cioè non s'incorre in situazioni tipo A=B+C, D=A-1 visto che le istruzioni sono di contesti diversi e si riferiscono quindi a registri diversi) o, nel caso d'istruzioni "non parallelizzabili" a causa delle limitazioni delle pipeline, due istruzioni "di fila" dello stesso thread.

(scritto alle 5:14am dopo che il pupo ha deciso che io mi dovevo svegliare... e lui no)
_________________
Immagine Wannabe tecnico : Le pipeline | Registri, cache ed altre amenità | DMA, multitasking, interrupt e CPU "OS friendly" (work in progress) Immagine
Top
 Profilo Non connesso  
 
Visualizza ultimi messaggi:  Ordina per  
Apri un nuovo argomento Rispondi all’argomento  [ 12 messaggi ] 
-->

Tutti gli orari sono UTC +1 ora


Chi c’è in linea

Visitano il forum: Nessuno e 0 ospiti


Non puoi aprire nuovi argomenti
Non puoi rispondere negli argomenti
Non puoi modificare i tuoi messaggi
Non puoi cancellare i tuoi messaggi
Non puoi inviare allegati

Vai a:  
cron
Powered by phpBB © 2000, 2002, 2005, 2007 phpBB Group
Traduzione Italiana phpBB.it